
Apresentando a visualização do Hy4

29 de agosto de 2026 – Link Blog
Apresentando a visualização do Hy4. Nova entrada de texto de peso aberto (sem visão) LLM da empresa chinesa Tencent hoje: 770B de parâmetros totais, 49B de parâmetros ativos, janela de contexto de token de 1M.
Este é um grande aumento de tamanho em relação ao Hy3 anterior em julho, que era de 295 bilhões, 21 bilhões ativos e 256.000 contextos.
Recentemente, comecei a usar modelos de chat modelo para entender melhor suas capacidades. Aqui está o chat_template.jinja do Hy4 no Hugging Face, que inclui esta seção:
{%- if not reasoning_effort is defined %}
    {%- set reasoning_effort = 'high' %}
{%- elif reasoning_effort not in ('high', 'no_think') %}
    {%- if reasoning_effort is none %}
        {{- raise_exception('reasoning_effort error : None, should be no_think/high') }}
    {%- else %}
        {{- raise_exception('reasoning_effort error : ' + reasoning_effort + ', should be no_think/high') }}
    {%- endif %}
{%- endif %}
Portanto, parece que existem apenas dois níveis de esforço de raciocínio: “alto” (o padrão) e “no_think” (raciocinar por desativado).
Tentei meu prompt “Gerar um SVG de um pelicano andando de bicicleta” com o raciocínio alto padrão via OpenRouter e consegui o seguinte:
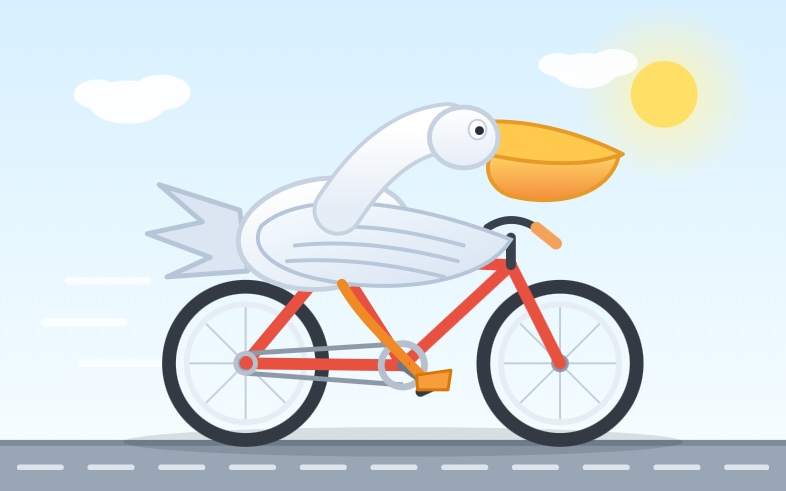
Citando o traço de raciocínio:
(…) Vamos talvez adicionar um capacete? Poderia melhorar o tema de pilotagem, mas pode obscurecer a cabeça. Talvez um pequeno boné ou capacete de ciclismo? O usuário não perguntou; pode adicionar capacete vermelho? Pode ser fofo. Mas pelicano com bico grande; um capacete pode obscurecer. Melhor talvez não.
Talvez adicionar óculos de sol? não.
Talvez adicione água? não.


